Catégorie : Non classé

  • Une légitime paranoïa publicitaire

    Une légitime paranoïa publicitaire

    Pas plus tard qu’hier, une anecdote m’a rappelé combien l’industrie publicitaire digitale s’est bien tiré une balle dans le pied.
    Dans mes deux derniers articles, j’ai déjà expliqué pourquoi beaucoup d’entre nous n’aiment pas être la cible de campagnes publicitaires, et même pourquoi certains refusent FLoC, qui se veut pourtant respectueux de leur vie privée.

    Aujourd’hui la question que je pose ici est la suivante : Facebook espionne-t-il nos conversations via le micro de nos téléphones ?

    Je vais tuer le suspens tout de suite, la réponse est non.

    Mais pourquoi la question peut-elle être légitimement posée ?

    Tout simplement parce la publicité sur Internet nous a habitués à nous sentir espionnés.

    Toutes les données disponibles ont été exploitées (géolocalisation permanente, produits consultés, etc.). Le ciblage est si précis que la plupart des gens pensent que leur nom, leur email et leur numéro de téléphone sont utilisés pour les cibler.

    La méfiance est donc tout à fait légitime.

    Hier, à une amie, qui devait passer là où nous avons confiné notre famille, j’ai envoyé le message suivant sur Messenger : « tu veux prendre du bois ? On en a trop ». Dans l’après-midi, elle m’a parlé (In Real Life, pas sur Messenger) d’un outil qui permet de fendre des bûches. Deux heures plus tard, elle m’a envoyé le message suivant : « je viens de recevoir une publicité pour l’outil dont je t’ai parlé !!! Tu crois que mon téléphone a espionné notre discussion ? »

    Difficile de savoir quel mécanisme a déclenché ce ciblage. Avait-elle déjà mentionné ce produit dans une autre conversation ? Etait-elle allée voir cet outil sur Amazon quelques semaines plus tôt ? Avait-elle acheté une hache sur Amazon ?

    Cela pourrait même être juste un coup de chance incroyable. La probabilité est infime me direz-vous. Mais des probabilités très faibles appliquées à ces réseaux de milliards d’utilisateurs, cela donne des effets très réels.

    Une chance sur un million, multiplié par un milliard de personnes, multiplié par 100 publicités par jour et par personne, ça fait des millions d’évènements complètement improbables qui se produisent tous les ans. Et dès que vous ajoutez un peu de ciblage (localisation à la campagne, mot « bois » dans Messenger, recherche de hache sur Amazon, que sais-je encore ?), il devient très probable que chaque individu soit témoin d’un de ces hasards improbables.

    Quand j’avais 10 ou 15 ans, un médium a été invité en prime-time à la télévision. Il promettait de dire l’avenir de certains téléspectateurs, et de réparer des montres à distance ! Il fallait pour cela respecter une procédure :

    • apporter une montre en panne devant l’écran
    • la tenir dans ses mains quelques minutes en pensant très fort à elle
    • ne la remonter que sur ordre du médium
    • appeler le standard téléphonique de l’émission si la montre se remettrait à marcher

    Le standard s’est vite trouvé submergé d’appels !
    Faisons un petit calcul rapide. Si une montre sur 10 000 était juste un peu coincée (c’est très peu, vous me l’accorderez), elle a pu se décoincer lors de son transport ou lorsqu’elle a été remontée. Cette anecdote est racontée dans ce vieil article : « Dans son ouvrage Le grand bluff (page 17), Gérard Majax explique que les montres anciennes ne se cassent pas complètement. Elles s’arrêtent mais il suffit de les secouer un peu tout en réchauffant leur graisse pour qu’elles puissent fonctionner un temps… « Les horlogers experts ont été catégoriques sur ce sujet » affirme-t-il. »

    Si quelques millions de personnes ont regardé l’émission, et tenté l’expérience, quelques centaines de montres ont pu miraculeusement « tomber en marche » au même moment. Un standard téléphonique de quelques postes, voire quelques dizaines de postes, a donc pu se faire submerger d’appels simultanés.

    Et ceux qui avaient envie de croire le médium ont été confortés dans leur croyance.

    De même, ceux qui croient que la publicité espionne leur micro de téléphone penseront détenir la preuve qu’ils avaient raison.

    Et ceux qui se posent des questions se trouvent troublés, et légitimement, car on ne leur propose aucune réponse satisfaisante.

    Enfin notre cerveau est ainsi fait que l’on va beaucoup plus se souvenir du trouble ressenti pour une publicité hyper-ciblée comme celle-ci, que des cent autres qui n’ont rien déclenché en nous. On croira donc que le phénomène d’espionnage est beaucoup plus fréquent qu’il ne l’est en vérité.

    Non, les GAFA n’espionnent pas les utilisateurs via les micros ou les caméras de leurs téléphones. Mais dans cette ambiance de suspicion générale où la publicité nous a plongés, il n’en reste pas moins que l’effet de l’hyper-ciblage est dévastateur.

  • Les anti-FLoC

    Les anti-FLoC

    La semaine dernière, j’analysais les différentes raisons qui poussent les internautes à se méfier ou à rejeter le ciblage publicitaire.

    J’y mentionnais brièvement cet article, promettant d’y revenir. C’est chose faite aujourd’hui.

    Rappelons d’abord ce qu’est FLoC.

    C’est aussi un apéritif du Sud-Ouest, n’oublions pas nos fondamentaux !

    FLoC (Federated Learning of Cohorts) est la solution que Google développe pour Chrome, lorsque le navigateur n’acceptera plus les cookies tiers, quelque part en 2022.

    Le principe est le suivant. Lors de votre navigation, Chrome enregistre les pages que vous consultez. Il calcule un identifiant sur la base de ces pages. Par exemple, si vous visitez les pages A, B et C, cet identifiant sera peut-être 123. Si vous visitez les pages D, E et F, l’identifiant pourra être 4, 5, 6. Si un autre internaute visite les mêmes pages, le même identifiant sera remonté. Mais, et c’est là que ça devient intéressant, si quelqu’un a un comportement proche du vôtre, par exemple A, B et G, il aura un identifiant proche, par exemple 124.

    C’est un peu comme ça que fonctionne Shazam. Les musiques qu’il connaît ont un identifiant robuste. Lorsque vous shazamez une musique, le bruit alentour font que l’identifiant calculé par votre application n’est pas le même que celui calculé sur le morceau original. Mais il est proche, et Shazam peut donner le titre le plus probable que vous entendez.

    FloC va générer des millions d’identifiants, et en associer plusieurs à chaque requête publicitaire. Les acheteurs d’espaces publicitaires pourront connaître les identifiants qu’ils ont achetés, et comparer les performances (les clics, malheureseument le plus plus souvent) obtenues pour les différents identifiants.

    Ils pourront ainsi choisir d’acheter ou non tel ou tel identifiant, ou de moduler leurs prix d’achats, etc.

    Ces identifiants n’ont pas de signification humainement compréhensible. Mais j’imagine que des petits malins vont vite s’amuser à simuler des comportements de navigation sur Chrome, pour regarder quels identifiants sont générés, et construite une sorte de dictionnaire géant.

    Donc il sera possible de comprendre un peu mieux ce que représentent ces identifiants.

    Il n’en reste pas moins que ce sont des identifiants de comportement, en non d’individus ou de navigateurs.

    Comment alors remonter à des individus ?

    La théorie veut que le comportement de chaque individu est unique. Techniquement je suis d’accord, et philosophiquement je l’espère. Je crois fermement au libre-arbitre et à l’infinité de l’âme humaine.

    Aparté personnel.
    En classe de seconde, mon professeur de Français, Monsieur Pigeot, nous avait posé ce sujet de devoir : « un personnage médiocre peut-il être un héros de roman ? ». Je n’avais pas eu une très bonne note, car j’avais seulement développé mon sentiment que chaque humain est unique.
    30 ans après, j’ai écrit une nouvelle intitulée « pour en finir avec Monsieur Pigeot ». J’y décrivais un individu lambda, nommé Pigeot, qui devenait l’homme le plus important de toute l’humanité. En effet, 100 millions d’années après la disparition de l’homme sur terre, une forme de vie extra-terrestre découvre des preuves qu’une intelligence a vécu sur Terre. Tous les fossiles retrouvés sont analysés pour l’identifier.
    Jusqu’à ce qu’un morceau de la mâchoire de Monsieur Pigeot apporte une preuve indiscutablee : une dent artificielle ! Seule une espèce intelligente pouvait recourir à de telles pratiques. Monsieur Pigeot est ainsi devenu la preuve que l’humanité était intelligente. Sa mâchoire occupe désormais le centre du musée dédié à la première civilisation d’une exoplanète que ces extra-terrestres ont édifié à sa mémoire.
    Fin de l’aparté.

    Bref, je suis intimement convaincu que chaque individu est unique, et que donc, la réunion de tous ses comportements lui est unique.

    Si j’utilisais Chrome, je ferais partie d’une cohorte de fans de Borges. Je ferais aussi certainement partie d’une autre cohorte de spécialistes du programmatique. L’intersection des deux ne doit pas compter beaucoup de monde, vous en conviendrez.

    Donc, en ciblant ces deux cohortes, il devient théoriquement possible de me cibler, presqu’exclusivement !

    Et alors ?

    D’une part il y aura peut-être des mécanismes pour imposer une taille minimale aux cibles créées par cohortes.

    D’autre part, ce ciblage restera non nominatif, à la différence de ces ids calculés sur des adresses email que le marché nous promet.

    Enfin, la différence entre la théorie est la pratique me semble fondamentale.
    En admettant qu’il soit en théorie possible de retrouver un individu à partir de son comportement, cela se fera-t-il pratiquement ? Quelle peut-être la motivation pour mettre en place ce type de processus ? La lourdeur (analyse du comportement d’un individu identifié), voire la faisabilité même de cette collecte (qui d’autre que moi sait réellement ce que je fais ?) rendent ces pratiques si ce n’est impossibles, du moins non rentables.
    L’industrie de la publicité se fonde sur des mécanismes simples et peu coûteux. Un ciblage individuel via FLoC coûterait trop cher.

    Donc les anti-FLoC ont raison en théorie. Mais à moins que leur vie ait vraiment un intérêt énorme, personne ne déploiera les moyens nécessaires à les espionner. Et si on parle d’espionnage, on dépasse le cadre de FLoC. Le divorce de Bezos l’a montré, quand on veut, on peut. Mais encore faut-il vouloir ! N’est pas Bezos qui veut !

    Pour protéger la vie privée, il n’est pas nécessaire de mettre en place un système parfait. Il suffit de rendre son contournement trop cher pour que le marché l’accepte.

  • Et vous, ça vous fait quoi d’être une cible ?

    Et vous, ça vous fait quoi d’être une cible ?

    « Deux lions à l’affût dans la jungle » du Douanier Rousseau (détail)

    Pourquoi les publicités ciblées sont-elles massivement rejetées par le public ?

    Comme souvent, les raisons sont variées, et certaines, modérées, se nourrissent d’autres, plus extrêmes, pour exister par procuration.

    Regardons quelques motivations, en commençant par les plus soft.

    Aussi étonnant que cela paraisse 😉, il semblerait que certaines personnes n’aiment pas la publicité !
    Si, si, je vous assure, ça existe !

    Pour ces personnes, l’expérience utilisateur est perturbée par les publicités. Le fait que la publicité soit ciblée ou pas leur importe peu. La pub c’est mal. Point.

    Je me dis souvent que la loi Hadopi sur le téléchargement illégal de fichiers (films, musique principalement) n’a peut-être pas eu l’effet prévu, mais a atteint un autre objectif tout aussi important. Les très rares sanctions (coupure d’accès internet), et les moins rares avertissements ont été relayés par les médias et le bouche à oreille. Et grâce à cette communication, les jeunes ont été informés, souvent pour la première fois, que les contenus ont un coût, donc un prix.

    La semaine dernière, exilés à la campagne, confinement oblige, on a fouillé des cartons de vieux DVD. Nous avons regardé A bord du Darjeeling Limited (génial film de Wes Anderson en passant), et j’ai dû expliquer à mes garçons pourquoi on avait une expérience utilisateur aussi pourrie. En effet, sous prétexte d’éduquer le spectateur, l’éditeur du DVD imposait la diffusion d’un clip agressif (images et musique brutale) qui assimile le piratage à du vol, voire à un crime !

    OK, il faut bien éduquer le marché, mais ce clip a eu l’effet inverse de celui recherché. Ceux qui devaient le supporter étaient justement ceux-là mêmes qui avaient payé le DVD, pas les pirates !
    Evidemment, le clip ne pouvait pas être zappé. Ni les deux bandes annonces de trois minutes chacune (pour des films qui, 15 après, sont retournés dans leur légitime anonymat) qui le suivaient !!! En tout, 10 minutes d’attente (fois deux car j’ai eu la bonne idée de revenir au menu pour changer la langue ! Ma femme et mes enfants m’ont interdit de toucher à la télécommande).
    L’expérience utilisateur est tellement lamentable, que cette pratique, heureusement abondonnée, a dû en pousser plus d’un à télécharger illégalement des films pour éviter de se taper ces contenus.

    C’est un peu ce qui est en train de se passer en ce moment avec les bandeaux d’acceptation des cookies. OK, ça part d’une bonne intention (appliquer une loi qui vise à protéger nos données). Mais ces bandeaux perturbent l’expérience utilisateur, et mettent l’accent sur le ciblage publicitaire.

    Il faut bien sûr éduquer au ciblage publicitaire. Mais tel que c’est fait, dans un environnement agressif (p…. de bandeau !), le message ne peut pas être présenté de façon positive.

    Positive, la pub ?
    J’ai souvent entendu (même de la part de personnes qui travaillent dans ce secteur) : les sites n’ont qu’à trouver d’autres sources de financement. Plus facile à dire qu’à faire ! Les abonnements ne fonctionnent que sur les gros sites d’information. Et la parade du native n’est jamais que de la publicité qui se cache derrière de l’éditorial. Pour moi, c’est pire que de la publicité, car le contrat moral qui sépare l’information de la publicité n’est pas respecté.

    Alors oui, certains n’aiment pas la publicité, et ils n’ont pas tort !

    Ensuite, certains acceptent la publicité mais n’aiment pas le ciblage.

    Quand je dis que je travaille dans la publicité digitale, on me dit systématiquement « Ah oui, c’est toi qui me balance des pubs pour les chaussures que j’ai vues il y a trois semaines ? ».

    Il y a ciblage et ciblage.
    Recevoir une publicité ciblée sur un centre d’intérêt ne pose pas de problème à cette population. Soit ils ne se rendent pas compte que la publicité est ciblée, soit ils considèrent que la publicité ciblée leur évite de recevoir des messages inutiles (à la fois dérangeants pour l’internaute, et une perte sèche pour l’annonceur).

    Le problème, c’est l’hyper-ciblage.
    Ceux qui ne travaillent pas dans la publicité digitale ne peuvent pas deviner (et souvent ne peuvent pas comprendre, par manque de compétences techniques) que l’hyper-ciblage ne vise pas Laurent Nicolas, né le 7 mai 1970 à Sedan, mais qu’il vise l’identifiant uid=ff94d201-3b5b-47e8-a884-dd4315c37a4d (ce n’est pas mon vrai identifiant, n’essayez pas de me cibler 🙂 ).

    Pour tous ces gens, la majorité des internautes, le ciblage est fondé sur des données qui permettent de les identifier nomminativement !
    Avec ses publicités matraquées sans fin, Criteo a beaucoup fait pour éduquer le marché, à son corps défendant.
    C’est grâce à l’hyper-ciblage, les gens ont compris qu’ils étaient ciblés. Mais, faute d’explication, ils croient que Criteo connaît leur nom, leur adresse et leur téléphone. Et faute de capping (j’expliquerai un jour pourquoi Criteo ne met pas de capping), ce qui aurait pu être un service (dans cet article de 2012 (!), j’expliquais comment j’utilisais le retargeting comme pense-bête), est devenu une gêne.

    L’hyper-ciblage est responsable d’une partie du rejet de la publicité !

    Troisième catégorie, ceux qui refusent toute forme de ciblage.

    La confusion qui règne entre données individuelles et données personnelles est utilisée à dessein par ceux qui refusent tout ciblage, et tout traçage.

    Ceux-ci installent donc des adblockers, non seulement pour l’expérience utilisateur, mais aussi pour refuser tous les types de cookies, même ceux qui sont liés à du comptage de visiteurs sur des sites.

    On trouve dans cette catégorie de nombreux informaticiens, qui effacent leurs cookies de session, utilisent le moteur de recherche Qwant, et le navigateur Brave. Eux ne peuvent pas être accusé de ne pas comprendre la différence entre un cookie et un numéro de téléphone. Ils rejettent tout traçage. Point.

    Ces arguments de contrôle et de protection de la vie privée sont tout à fait acceptables.
    En revanche, je décroche lorsqu’ils dérivent vers des théories complotistes. Comme les données sont personnelles, les mouchards espions (comme il convient d’appeler les cookies pour renforcer leur dangerosité) permettent à ceux qui dirigent le monde (eux seuls savent qui, mais passons) de tracer nos actions sur Internet, mais aussi le contenu de nos ordinateurs, nos comptes bancaires, nos emails et nos conversations privées.

    Si tout ceci est effectivement possible, ce n’est pas avec des cookies publicitaires, mais avec des virus. C’est une toute autre histoire. Mais dans le complotisme, l’amalgame est roi !

    Alors que penser de cet article de DuckDuckGo qui montre comment ne pas être ciblé par Floc (le système de ciblage anonyme que Google développe) ?
    Je voulais écrire sur ce sujet, mais mon post est déjà assez long, revenez la semaine prochaine !

    Personnellement, je n’ai aucun problème avec la publicité ciblée :

    • je sais pertinemment que c’est un identifiant anonyme qui est suivi et ciblé
    • je préfère avoir des publicités pour des produits que je pourrais potentiellement acheter, plutôt que pour des serviettes hygiéniques ou des montres de luxe

    En revanche, j’ai des problèmes avec la publicité (ciblée ou non) :

    • lorsqu’elle est matraquée sans capping
    • lorsqu’elle prend trop de place par rapport au contenu (sites « arbres de Noël »)

    Et vous, dans quelle catégorie vous situez-vous ?

  • Vive le spam ? 😱

    Vive le spam ? 😱

    Avec les ids unifiés, l’email devient central dans la stratégie des marques. De nombreuses adtech appellent les annonceurs à se créer des bases first party en collectant les emails de leurs clients.

    Ces collectes ont officiellement pour but d’anonymiser ces emails en les remplaçant par un hash (série de chiffres et de lettres unique pour chaque email, mais qui ne permet pas de retrouver l’email initial).

    Mais cette résurrection (j’écris cet article la semaine de Pâques) de l’email n’aura-t-elle pas d’autres répercutions négatives ?

    Depuis quelques années, j’ai mis en place la stratégie suivante. Je crée deux emails, une human friendly partagée avec des humains, et une, machine ready, que je réserve aux formulaires.

    Pourquoi ? Parce que je n’ai jamais réussi à garder une adresse email propre. OK, la plupart du temps, on peut se désabonner des listes. Mais les bases d’emails sont revendues, copiées, partagées. Et vous savez tous qu’on reçoit des emails de newsletters auxquelles on est soit-disant abonnés, mais qu’on n’a jamais autorisées à nous écrire. Et les liens pour s’en désabonner n’empêchent pas les revendeurs de revendre vos adresses.

    Ces emails, qui se présentent comme des newsletters, sont en fait des spams.

    Petit aparté culturel. Savez-vous d’où vient l’utilisation du mot spam pour désigner des emails indésirables ? De ce sketch délirant des Monthy Pythons, où la répétition seule du mot spam suffit à vous faire pousser des boutons !

    Avec mes deux adresses emails, je garde ma boite human friendly propre. Sur mon adresse à spam, j’ai 400 messages en six mois, dont une centaine non lus.
    D’accord, certains humains bien intentionnés entrent mon adresse human friendly dans des serveurs. Par exemple pour m’inviter à un événement. Je reçois alors des messages automatiques sur cette adresse.
    Mais c’est rare, et la désinscription reste gérable. Libre à moi de remplacer cet email par mon email machine ready.

    Que vont faire les annonceurs et les éditeurs avec nos emails hashés ? Ils vont les revendre (enfin les adtechs vont les revendre), les copier, les partager. Tout comme les spammers.

    Si les règles sont claires, pourquoi pas.
    Mais les annonceurs résisteront-ils à la tentation d’envoyer des emails à ces nouvelles adresses collectées pour d’autres buts (la publicité adressée anonymisée) ? Je prends le pari que la tentation sera trop forte.

    Que va-t-il se passer ? Des annonceurs jusqu’alors réticents à collecter votre email vont vous l’imposer plus ou moins discrètement. Lisez cet article du Wall Street Journal. Une marque de Gin a utilisé sa base d’emails pour envoyer des messages ciblés (emails et instagram). Les taux de clics ont dépassé tous ceux mesurés sur des campagnes précédentes.

    Après Et merde, le clic revient, la fin du tout data va-t-elle renforcer le spam ?

  • Les répétitions sont fausses ! Même (et surtout) avec des cookies !

    Les répétitions sont fausses ! Même (et surtout) avec des cookies !

    Toute mon estime pour le premier qui commente cet article avec le lien entre le thème et l’illustration !

    La répétition est un peu mon dada. Dès 2012, j’avais fait une présentation à ce sujet à l’IREP (Institut de Recherche et Etudes Publicitaires).

    La répétition est importante pour l’internaute (enfin, pour que la publicité soit efficacement imprimée dans son petit cerveau disponible).

    Elle est aussi importante pour l’acheteur, l’annonceur, qui ne veut pas sous-investir (pas assez de répétitions) ou sur-investir (trop de répétitions).
    Qu’il se rassure, aujourd’hui il fait les deux ! Il investit trop et pas assez. Mais je ne développerai pas cette triste réalité aujourd’hui, je m’attaque à une autre triste réalité, et je reviendrai une autre fois sur la notion de distribution des contacts.

    On a cru que le digital allait permettre de calculer enfin la répétition. J’ai déjà parlé du mirage du capping, mais je n’avais pas assez insisté sur un point essentiel. La répétition (et donc le capping) sont pilotés par des cookies qui, comme nous tous, sont mortels.

    Quand on parle de répétition en publicité, on se place du côté des sciences cognitives, du bêta de Morgenstern, de la mémorisation des messages, bref, du cerveau. Un cookie a-t-il un cerveau ? Non, mais l’individu en a un.

    Je viens de montrer en quoi les cookies et les individus sont deux concepts distincts. Je vais ici enfoncer le clou.

    Les cookies sont non seulement multiples à un instant t. Mais leur espérance de vie est aussi beaucoup plus courte qu’on le croit.

    Leur durée est limitée à un an par le RGPD. Mais c’est un an reconductible à chaque fois que le cookie est déposé, c’est à dire potentiellement à chaque fois qu’il est lu. Donc l’effet réglementaire n’est peut-être pas si important.

    Le cookie est supprimé à chaque fois qu’on change d’ordinateur. Ok il existe quelques fous furieux comme moi qui les recopient lorsqu’ils installent un nouvel ordi. Mais on est rares.

    Les cookies sont effacés dès que l’on quitte une session privée. Ils n’ont duré que quelques minutes, juste le temps pour que les technos publicitaires les enregistrent et les synchronisent. Pour rien.

    Ils sont supprimés automatiquement à chaque session chez tous ceux qui demandent à leur navigateur de le faire à chaque fois qu’ils le ferment.

    Bref, en plus de découper artificiellement notre vie digitale par ordinateur, navigateur et technologie publicitaire, au sein même de ces silos, les cookies sont très souvent renouvelés.

    A un bout de la chaîne, on a moi, qui n’efface jamais mes cookies, certains qui les effacent plusieurs fois par jour ! Et en moyenne, ça fait un paquet de cookies. Rien d’étonnant donc à ce que le nombre de cookies français dépasse allègrement d’un facteur 10 (sur un an) le nombre d’habitants en France !

    Or la répétition se fonde sur les cookies. Vous prenez le nombre d’impressions, vous le divisez par le nombre de cookies, et vous obtenez la « répétition ». Sauf que votre nombre de cookies est surestimé d’un facteur important, même sur la durée d’une campagne (un mois par exemple). Si chaque individu a trois cookies par mois, la répétition d’une campagne devrait être multipliée par trois !

    Avant l’internet, les répétition étaient estimées à l’aide de statistiques. On jugeait que c’était compliqué et que le digital allait améliorer tout cela. On l’a cru, au point de porter aux nues les cookies, et de négliger leurs limitations.

    Mais je prends ici le pari : les méthodes statistiques, même imparfaites, ne surestimaient pas la répétition d’un facteur trois !

  • Cookies et individus : les frères ennemis

    Cookies et individus : les frères ennemis

    Longtemps notre industrie de la publicité en ligne a idéalisé le cookie. On lui prêtait toutes les vertus, passeur d’information (cookie matching), identifiant unique (calcul de la répétition), sésame du profil (si, si je vous assure, je suis un chat !), baron du comportemental (je sais que tu veux ces chaussures rouges, je le sais !).

    Ca m’a toujours paru bizarre. Et plus encore, lorsque le cookie était vu par certains comme un individu.

    Alors que cookie et individu désignent deux concepts très éloignés l’un de l’autre.

    Étymologiquement, individu signifie individuum, « ce qui est indivisible ».

    Le cookie, lui, est divisible. Pire encore, il est divisé.

    Un cookie n’est qu’un artifice technique, dérivé du magic cookie inventé en 1979 pour désigner une donnée que l’on stocke sans la changer. On est loin de la notion d’être pensant, hein ?

    Entrons un peu dans le détail, sans passer à un discours technique. Le cookie est un fichier géré par le navigateur. Dans ce fichier, chaque domaine (ex : bidule.com) peut écrire et lire ses propres données.

    Voyons maintenant les implications de cette définition.

    « Navigateur » implique que :

    • le cookie est lié à un ordinateur. Deux ordinateurs, deux cookies.
    • le cookie est lié à un navigateur sur cet ordinateur. Deux navigateurs, deux cookies. Deux navigateurs sur deux ordinateurs, quatre cookies. Si on tient compte de la synchronisation des comptes sur Chrome, on peut estimer à la louche qu’on a trois cookies plutôt que quatre.

    « Domaine » implique que :

    • le cookie est lié exclusivement au domaine qui l’a déposé. Deux domaines, deux cookies.
    • si le domaine du cookie n’est pas celui de la page qui est chargée, le cookie n’est même pas déposé sur Safari et Firefox, et il ne le sera plus sur Chrome en 2022. L’utilisation du cookie tiers pour éviter le problème « deux domaines, deux cookies » est en train de disparaître.

    On a donc un entonnoir de silos.
    Prenons un individu que nous appellerons A. A utilise :

    • un ordinateur familial
    • un ordinateur professionnel
    • un smartphone
    • un ipad

    Sur les deux ordinateurs, il utilise Firefox.
    Premièrement parce qu’il est resté naïf et croie encore aux projets open-source, deuxièmement parce qu’il ne souhaite pas que Google sache vraiment tout de lui et troisièmement parce qu’il a ses signets, son historique et ses cookies (hé oui, certains choisissent de ne pas effacer leurs cookies).
    Mais certains sites ne fonctionnent déjà plus bien sur Firefox. Il doit donc passer parfois sur Chrome.
    Enfin, certaines applications de ses ordinateurs Apple et de son iPad ouvrent uniquement Safari.

    A a donc trois navigateurs sur chacun de ses deux ordinateurs. Ca nous fait donc six cookies par domaine.

    A navigue sur Internet pour son boulot, et pour ses besoins personnels. Il n’aime pas trop mélanger les genres et il doit parfois être connecté avec un compte Google professionnel, parfois avec un compte Google personnel. Il a donc deux profils sur son navigateur Chrome professionnel.
    On passe à sept cookies par domaine.

    Parfois, il veut faire un cadeau à sa femme (😉) et passe en navigation privée. C’est comme s’il passait sur un nouvel ordinateur à chaque fois. Disons que l’on est alors au moins huit (disons dix) cookies par domaine et par mois.

    Plaçons-nous maintenant dans le cas le PLUS favorable aux cookies. Nous sommes en 2021, et A utilise Chrome. Les cookies tiers existent encore. A reçoit donc des cookies de toutes les technologies publicitaires :

    • doubleclick, googlesyndication (Google)
    • adnxs (AppNexus, Xandr)
    • smartadserver (Smart)
    • criteo
    • taboola…

    Chacune de ces technologies est en silo, c’est à dire que ses cookies ne sont pas lisibles par les autres. On a donc une vingtaine de ces domaines publicitaires en quelques minutes de surf.

    OK, ces domaines font du cookie-matching a tour de bras. Mais

    1. encore faut-il qu’il marche. Les taux de matching sont rarement au dessus de 60%, et jamais au dessus de 85% !
    2. encore faut-il que le consentement ait été donné pour faire le matching.

    Bref, sans même forcer le trait, A se retrouve avec Au moins vingt cookies publicitaires, que l’on peut réduire à dix avec le cookie-matching. Mais attention, on parle toujours de 10 cookies PAR navigateur !

    Et on a estimé que A utilise 10 navigateurs (réels ou virtuels) par mois. On arrive donc à environ 10 x 10, soit 100 cookies publicitaires !

    OK, ce nombre peut être ramené à 50 par le jeu du matching des adresses emails encryptées.

    Un seul individu, sans être particulièrement atypique, peut donc correspondre à 50 identifiants « uniques » !

    Et ça marche aussi dans l’autre sens.

    L’ipad et l’ordinateur personnel de A sont utilisés par son conjoint et leurs deux enfants. Donc 30 de ses identifiants (trois navigateurs réels + deux navigateurs virtuels sur ordinateur + un navigateur sur iPad, pour chacune des cinq technologies publicitaires après déduplication, soit 30 combinaisons) correspondent en fait à quatre individus !

    Dans le meilleur cas, on a donc 50 identifiants publicitaires pour lesquels 20 correspondent à un même individu, et 30 à potentiellement quatre individus.
    Dans le pire cas, on n’a rien (c’est plus simple).

    Cela signifie :

    1. que quatre comportements différents peuvent être associés à tort à un même individu, sur 30 identifiants qui ne devraient pas être regroupés
    2. que 20 profils ne peuvent pas être regroupés alors qu’ils le devraient

    Placer les cookies et les individus au même plan a autant de sens que comparer Arnold Schwarzenegger et Dany De Vito.

    Et on nous dit que la disparition des cookies est une perte énorme ?

    C’est une perte énorme si on croit encore à leur pureté et à leur perfection ! Mais si on regarde ma démonstration, on comprend vite quelles précautions il faut prendre…

    Le monde publicitaire va passer du tout data au peu de data et au contextuel. La précision des solutions de ciblage va diminuer. OK, je l’admets.
    Mais elle va diminuer non pas depuis un optimum de qualité, mais depuis une situation déjà discutable. J’ai récemment entendu (sans avoir pu comprendre la source), qu’un fournisseur de data estimait sa propre qualité à 47% ! C’est à dire que sa donnée était fausse dans 53% des cas !

    Alors, abandonner un système de qualité moyenne, qui a érigé des statues à un identifiant technique, pour développer un système qui remet l’individu au centre de ses analyses, je pense qu’au final, notre industrie va y gagner !

  • Contextuel, un buzzword à mille facettes

    Contextuel, un buzzword à mille facettes

    Le contextuel a toujours existé.
    Enfin, à l’échelle du web, soit à 23 heures 59 minutes et 59,99987 secondes, si on rapporte la création de l’univers sur 24 heures.

    Bref, à notre échelle de vermisseaux de la publicité digitale, le contextuel était là depuis longtemps, avant même Google, c’est tout dire !

    Pourtant, c’est le buzzword de 2021. Tout le monde n’a que ça à la bouche, même nous !

    Comment définir le contextuel ?
    Trop souvent, notre industrie le limite à l’analyse des pages qui servent la publicité. On en arrive presque à identifier contextuel et sémantique.

    Je préfère vous proposer ici une définition différente, en creux.

    La publicité contextuelle regroupe toutes les méthodes d’achats publicitaires qui ne se fondent pas sur des données personnelles.

    Pendant les 20 premières années de sa petite vie, le jeune Contextuel avait cru être né sous une bonne étoile (les années 2000-2010). Faute d’alternative, il se voyait un avenir aussi radieux que son oncle de la télévision, indéboulonnable depuis les années 1960…

    Arrivèrent ensuite les dures années de l’adolescence (2010-2020). Là, un jeune garçon, fraichement débarqué dans sa classe, lui a volé la vedette. Appelé Data, il affichait une réussite insolente. Il avait aussi un petit côté canaille, voire délinquant, car on ne savait pas toujours d’où il tirait ses ressources.

    Mais un double phénomène est venu remettre Data à sa place. D’un côté, les lois se sont durcies. Ses petites escroqueries et ses même simples bidouilles sont devenues de plus en plus difficiles à réaliser. D’un autre côté, ses camarades ont commencé à se méfier de sa petite gueule d’ange, voire à lui prêter tous les maux ! A la récréation, plus personne ne voulait lui donner ses cookies (qui étaient devenus la monnaie d’échange au lycée) !

    Contextuel s’est donc précipité pour saisir sa chance. Mais à l’aube de l’âge adulte, il s’est retrouvé à l’heure des choix. Quelle profession allait-il embrasser ?

    Fallait-il partir sur la voie des mots-clés, comme Grapeshot ? Ou aller vers le sémantique, comme Qwarry ?

    Après quelques recherches, il s’aperçut que les options s’avéraient encore plus variées qu’il ne pensait :

    Les études reviennent fort. De nombreuses informations peuvent être collectées à l’aide de sondages et utilisées pour orienter les achats sur des contenus en adéquation avec des valeurs des marques.
    Une société comme Hotspex mélange études, conseil et données contextuelles pour optimiser les achats publicitaires.

    Il existe aussi d’autres sources d’informations contextuelles. La météo par exemple. D’accord, il faut connaître la position du contact, mais la précision n’a pas besoin d’être celle du drive-to-store par exemple.
    Et il n’y a pas que la bière qui suit la météo. Les crèmes solaires, les médicaments contre l’allergie aussi, et même les batteries de voitures !
    Planalytics est une société qui analyse les corrélations entre votre business et la météo, et propose des solutions de ciblage adaptées.

    Même l’analyse des fake news a à voir avec le ciblage contextuel. J’ai déjà parlé de la relation ambivalente entre la publicité et les fake news. NewsGuard, qui se veut l’outil de confiance sur Internet, vient par exemple de rejoindre la place de marché contextuelle de Peer 39.

    Et je ne parle même pas ici de l’approche d’Implcit, encore différente et pleine de promesses ! Teasing…

    Le contextuel est encore jeune. Il va prendre plusieurs de ces routes en parallèle. Certaines ne le mèneront peut-être nulle part, d’autres dans des régions inexplorées…

  • Thémis, déesse des études ?

    Thémis, déesse des études ?

    Quand on a créé Alenty avec Nico en 2007, on venait déjà du monde des études (NetValue, rachetée par Nielsen//NetRatings).

    Je venais de terminer un MBA, mes connaissances en analyse stratégique étaient encore toutes fraîches.
    J’avais donc en tête les KSF (Key Success Factors, facteurs-clé de succès) du secteur des études.

    Nous étions en train d’inventer une nouvelle industrie, la mesure de la visibilité publicitaire.
    Personne avant nous n’avait ne serait-ce que pensé que l’on pouvait mesurer la visibilité des publicités sur Internet.
    Aucun modèle économique n’existait, il fallait tout inventer.

    Alors, dès notre première embauche, lorsque je formais nos jeunes ingénieurs à leur nouveau métier, j’insistais lourdement sur l’un de ces facteurs-clé : la qualité.
    Et pour commencer, il nous fallait créer de la confiance dans cette nouvelle mesure. Je disais : « on va mettre des années à créer de la confiance, mais on peut la perdre en 24h ».

    On a donc constamment cherché à améliorer notre mesure, même après l’acquisition par AppNexus en 2014.

    Lorsque la concurrence est arrivée, vers 2009-2010, les comparaisons sont venues avec.
    La principale différence venait de l’univers mesuré. Partis les premiers, nous avions une longueur d’avance et pouvions mesurer plus de cas (iframes cross domain sur Chrome, publicité mobile…). Nos concurrents les considéraient « unmeasurable ».
    Puis, une fois rapportés à des univers comparables, on pouvait analyser l’indicateur phrare : le taux de visibilité.

    Les différences étaient très limitées avec nos concurrents qui avaient suffisamment investi en R&D.
    Et là, dans la grande majorité des cas, Alenty présentait un taux de visibilité légèrement inférieur aux autres.

    Pourquoi ?
    Parce que nos ingénieurs avaient bien retenu la leçon : la qualité de la mesure était une priorité. Dès qu’ils découvraient un cas de non visibilité (utilisation de css, empilement d’objets…), ils cherchaient une solution pour le détecter.

    Et parfois, cette obsession de la qualité pouvait nous jouer des tours. Certains sites se montraient mécontents de nos résultats, car une visibilité plus faible ne faisait pas leurs affaires. On pourrait penser qu’en face, côté agence, notre orthodoxie de la qualité aurait été mieux accueillie. Mais pas toujours ! Certaines agences s’engageaient sur des taux de visibilité qu’elles avaient du mal à atteindre. Et préféraient une mesure plus « gentille ».

    Fallait-il pour autant réduire nos efforts de R&D, et baisser la qualité de notre mesure pour aller dans le sens de nos clients ?

    Je m’y suis toujours refusé. Et cette qualité a été largement reconnue lors de l’acquisition par AppNexus.

    Les dirigeants de Facebook ont-ils eu ce type de conversation ?

    Les récents documents publiés dans le cadre d’un procès semblent le démontrer. Facebook savait que les audiences prévues étaient surestimées. Les faux comptes, les comptes fantômes (connus) et dupliqués étaient utilisés dans les estimations de volumes.
    Mais Facebook n’est pas une société d’études. Et ses facteurs-clé de succès ne privilégient pas la qualité de la mesure.

    Ce n’est pas la première fois que Facebook se fait prendre la main dans le sac. Un précédent scandale avait porté sur la durée des vidéos, surestimée de 60 à 80% !
    A chaque fois, deux problèmes ont été remontés :

    • comment se fait-il qu’on laisse Facebook être juge et partie ?
    • pourquoi les conséquences sont-elles si faibles ?

    Lorsqu’AppNexus a intégré la visibilité dans sa place de marché, on aurait pu dire que l’on devenait juge et partie. Mais non :

    • AppNexus ne possède pas l’inventaire, donc n’avait pas intérêt à surévaluer la visibilité. Au contraire, AppNexus prenait un risque en achetant des espaces qui ne seraient payés que si les publicités étaient visibles.
    • AppNexus autorise tous les autres mesureurs de visibilité à vérifier ses propres mesures. Facebook (et Google) non.

    Ces géants sont-ils trop gros pour être mesurés par des tiers ? Non. Les capacités des serveurs autorisent maintenant des volumes inimaginables il y a seulement quelques années. Les mesureurs peuvent mesurer les GAFA.

    La vie privée des utilisateurs de Facebook serait-elle en danger ? C’est l’excuse facile, brandie dès que l’on veut fermer toutes les portes de ces walled gardens.
    Là encore, non. La mesure (visibilité, audience, complétion) se moque éperdument de l’identité de ceux qu’elle analyse.

    Une mesure indépendante serait donc possible.

    Sauf qu’un tiers mesureur, s’il avait fait un MBA, aurait érigé la qualité au rang de vertu cardinale. Et il aurait immédiatement corrigé l’erreur d’estimation de l’audience, ou de la durée des vidéos.

    Et Facebook aurait perdu 5%, 10% 15% (?) de chiffre d’affaires.

    Ce n’est pas le choix qui a été fait. Facebook a semble-t-il préféré attendre jusqu’à ce que le pot-aux-roses soit découvert.

    Tout autre société aurait perdu de grosses plumes dans une telle situation. Beaucoup même auraient coulé !
    Mais lorsqu’on est incontournable, too big to fail, on peut se permettre de dire « oops, pardon, je m’ai trompé ! » et faire un petit cadeau en dédommagement.

    Et la qualité de la mesure n’a pas besoin d’être un facteur-clé de succès de son département « mesure ».

    Thémis, la déesse de la justice, brandit une balance, symbole de la qualité de ses jugements. Elle a les yeux bandés, pour ne pas voir qui elle juge, symbole de son indépendance. Et si on en faisait aussi la déesse des études ?

    Thémis, déesse de la justice. Et des études ?
  • Les rapports ambigus de la publicité et des fake news

    Les rapports ambigus de la publicité et des fake news

    Dans mon dernier article, je parlais de l’adéquation entre un contenu et un visiteur du point de vue de la visibilité publicitaire. Adéquation soutenue par la qualité ressentie.

    Développons aujourd’hui cette notion de qualité ressentie d’un contenu.

    Je pourrais inclure de nombreuses dimensions dans cette notion de qualité, comme l’orthographe, la profondeur du propos, le style… Mais je ne me focaliserai aujourd’hui sur un seul axe, la véracité.

    Les fake news sont un thème qui me tient fort à cœur depuis des années. C’est je pense un des maux majeurs de notre époque, j’en ai déjà parlé.

    Quel est alors le rapport entre les fake news et la publicité ? Comme de nombreux sites éditoriaux, les sites de fake news sont souvent financés par la publicité.

    Publicités floutées sur un site complotiste

    Un ami m’a demandé conseil lorsqu’il s’est intéressé à la brand safety. Ma réponse alors avait été « tu vas découvrir la portée du mot hypocrisie ».

    Je voulais dire par là qu’il allait mesurer la différence entre les discours et la réalité. Mais je nuance aujourd’hui la portée du mot « hypocrisie ».

    Il est hypocrite de dire « les fake news sont des sites de mauvaise qualité sur lesquels je ne veux pas acheter de l’espace publicitaire ». Car cette phrase est ambigüe.

    Les sites de fake news sont-ils de mauvaise qualité ?
    Tout dépend, malheureusement, du point de vue.

    Moralement, cela ne fait pas de doute.
    Ceux qui rattachent les fake news à la liberté d’expression ne font que profiter d’un vide juridique qui ne punit pas la désinformation massive dès lors qu’elle s’attaque au bien public. La démocratie, la science, la justice sont autant de biens publics que l’on peut et que l’on doit challenger avec des arguments. Mais pas en martelant des mensonges jusqu’à ce que la population se rallie à la voix la plus fréquemment entendue.

    Des annonceurs peuvent dire « Je ne veux pas financer des sites de fake news » . C’est un argument moral, tout à fait légitime.
    Voilà pour la morale, ce n’est pas la ligne éditoriale de ce blog.

    Mais qu’en est-il de l’efficacité publicitaire ?

    C’est là qu’une double erreur est souvent commise. On juge un site à l’intérêt qu’on lui porte. Alors qu’il doit être jugé à l’aulne de l’intérêt que ses visiteurs lui portent.
    C’est vrai pour la visibilité. C’est aussi vrai pour l’image de la marque, son branding.

    Dire que l’on ne veut pas que sa marque soit dans tel ou tel contenu, pour des questions d’efficacité, c’est discutable. On peut considérer que la pornographie est dégradante, mais ce n’est certainement pas le point de vue de ses consommateurs. Si l’occasion leur en était donnée, ils ne jugeraient peut-être pas que les publicités placées sur ces sites sont dévalorisées par leur environnement.

    Idem pour les fake news. Un lecteur de ces sites les juge positivement, et associera positivement une marque au contenu dans laquelle elle s’affiche.

    La loi de 2018 sur la transparence de la publicité vise à protéger l’annonceur des univers de diffusion « préjudiciables à l’image de sa marque ou à sa réputation ». La difficulté de mise en œuvre de cette loi, c’est que, justement, du point de vue du visiteur du site, tel contenu n’est pas préjudiciable à la marque. En revanche, lorsqu’un non-visiteur d’un tel contenu voit la publicité de l’annonceur, il peut juger que c’est préjudiciable. Mais normalement, sauf visite de contrôle et copie d’écran, il ne le verrait pas.

    En effet, dans le monde merveilleux du digital, la publicité n’est affichée qu’à celui auquel elle est destinée.
    Je schématise à dessein, mais on se retrouve à devoir chercher des contenus que l’on désapprouve, pour créer le contexte dans lequel l’annonceur pourrait se sentir offensé !
    En résumé, l’annonceur a le droit de penser qu’un contenu est préjudiciable à l’image de sa marque, mais dans les faits, l’impact reste certainement faible.

    Vient ensuite la question de l’adéquation entre la publicité et le contenu. Je ne sais pas quel processus cognitif tordu peut assimiler une tondeuse à gazon et une vidéo porno. L’impact branding, peut-être pas négatif pour le visiteur comme on l’a vu, aura en revanche peu de chances d’être positif.

    Pour les fake news, la variété des sujets peut créer des poches d’efficacité publicitaire. Vanter un produit touchant à la santé (yaourt ou huile essentielle par exemple) sur un site qui diffuse de fausses informations sur la pandémie de Covid, ça peut marcher. On touche à la santé, le cerveau peut créer des connexions intéressantes pour aider la mémorisation.

    Oui, ça me fait bien mal au c… de l’écrire. Ça peut marcher…

    Le jugement par l’efficacité, une double erreur, disais-je. Car, si on considère vraiment qu’un article de fake news est de mauvaise qualité on devrait relire mon article sur les clics. Les clics se nourrissent de la déception du lecteur. On ne clique pas sur une pub qui va nous arracher d’une lecture passionnante. On clique souvent pour quitter une page. Soit parce qu’on a fini de la consommer, soit parce qu’elle n’est pas intéressante.

    Donc, un site de fake news peut, par sa piètre qualité, se révéler efficace pour la publicité à la performance.

    Ça me fait doublement mal au c… d’écrire ça !

    La question de la publicité sur les sites de fake news ne doit donc pas se poser en termes d’efficacité. Car la démonstration de la non-efficacité demandera de gros efforts et ses résultats ne seront pas garantis.

    Une agence publicitaire jugée sur l’efficacité de ses achats d’espaces pourra donc être tentée de ne pas se priver d’inventaires sur des sites que l’annonceur n’assumera pas. Arguments de performance à l’appui.

    Ce n’est pas pour des arguments d’efficacité, mais pour des questions essentiellement morales qu’il ne faut pas acheter de publicité sur des sites de fake news. Pour ne pas financer des individus ou des entités qui cherchent à détruire par des mensonges nos biens communs, justice, science, et démocratie.

  • Visibilité : la rencontre d’un site et d’un visiteur

    Visibilité : la rencontre d’un site et d’un visiteur

    Qu’est-ce qui fait qu’une publicité sur internet est visible ? 

    On parle de la mise en page des sites, du fameux « above the fold ». Mais est-ce nécessaire ? Est-ce suffisant ?

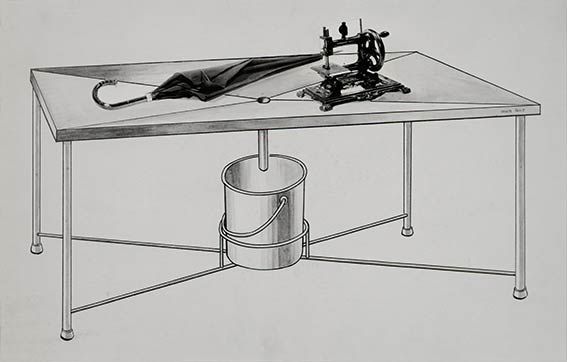
    La visibilité d’une publicité naît de la rencontre d’un visiteur et d’un contenu. Ce n’est pas aussi absurdement beau que la rencontre inventée par Lautréamont, entre un parapluie et une machine à coudre sur une table de dissection, mais visiteur et contenu restent parfois difficilement compatibles.

    Pourquoi un visiteur vient-il sur un site ? 

    • Parce qu’il connaît ledit site
    • Parce qu’il a suivi un lien depuis un autre site
    • Parce qu’il a fait une recherche

    Ces trois raisons sont classées par ordre descendant d’intérêt pour le visiteur.
    L’intérêt, voici le parent pauvre de la visibilité. 
    On connaît bien le taux de rebond, dans une perspective de performance : le pourcentage de visiteurs qui ne voient qu’une page. Son pendant « branding » n’a pas de nom mais il existe pourtant bien : le pourcentage de visiteurs qui ne consultent pas la page. Il est plus dur à mesurer (il faut soit mesurer le temps passé, soit mesurer le scroll dans la page). Et il est tout aussi important pour la visibilité.

    Quel rapport avec la visibilité ? 

    D’après la définition de l’IAB, une publicité est visible si plus de 50% de ses pixels sont visibles à l’écran pendant plus d’une seconde consécutive. 

    Résultat, si l’internaute passe moins d’une seconde sur la page, aucune publicité ne peut être visible. Si on ajoute les temps de mise aux enchères et de chargement de la publicité, on atteint facilement les deux secondes. CQFD

    Il se passe donc avec la visibilité le même effet pervers que l’on constate en performance.

    Si on force la visite, le taux de rebond augmente :
    Mettez une pub intrusive, avec une croix plus petite que la précision maximale du doigt ou de la souris, vous aurez des clics involontaires.  Parfois avant même la page chargée, le visiteur par accident repartira.
    Mettez des titres ou des messages (liens sponsorisés par exemple) qui survendent un contenu, et vous aurez des visiteurs déçus, qui partiront immédiatement.
    Mettez un contenu de mauvaise qualité, les internautes partiront vite. Deux secondes suffisent souvent pour juger de la qualité d’un contenu. 

    Dans tous ces cas, les publicités ne seront pas visibles.

    Petit apparte : la qualité d’un contenu est relative aux attentes d’un visiteur. Une belle étude scientifique peut faire fuir un platiste, qui sera ravi de tomber sur une page qui va dans son sens, et que vous et moi jugerons absolument nulle. Il n’existe pas de qualité absolue, seulement l’adéquation entre la machine à coudre et le parapluie.

    Supposons maintenant que le visiteur décide de rester un peu sur la page (ou dans l’application). En fonction de l’intérêt qu’il trouve au contenu, il y passera plus ou moins de temps, il descendra plus ou moins dans la page. Il verra un nombre plus ou moins grand de publicités. 

    Des publicités en tout bas de page peuvent être visibles, à condition que le contenu amène le visiteur dans ces zones parfois inexplorées.
    OK, il y a quelques années j’ai vu des pages (des clubs de foot amateur qui étaient tous sur le même modèle), où 10 publicités s’empilaient en bas de la page, au moins deux écrans plus bas que le dernier contenu ! Ca, c’est une arnaque, que la mesure de la visibilité publicitaire a mise en évidence. Ca reste une exception.

    Du point de vue de la visibilité publicitaire, la mise en page ne doit avoir qu’un but : placer la publicité dans les zones d’intérêt du contenu. Une publicité en bas de page sera donc vus par ceux que le contenu intéresse.
    Il n’y a pas de bonne ou de mauvaise mise en page, à condition que le contenu suive.

    Si je pouvais me mettre à la place des visiteurs d’un site (c’est à dire avoir les mêmes centres d’intérêt qu’eux), je pense que je pourrais prévoir le taux de visibilité des différents emplacements publicitaires.